FastFrames, ein Paper auf arXiv, stellt eine Familie autoregressiver Video-Diffusionsmodelle vor, die nach eigener Aussage interaktive Latenz ohne Qualitätsverlust erreichen (arXiv). Das kleinere 1,3B-Modell erzeugt auf einer B200-GPU einen Frame in 36 ms, also 28 Antworten pro Sekunde, und laut Paper entspricht seine Qualität der eines fast 8x langsameren State-of-the-Art-Modells. Wer ein Modell für Echtzeit-Video auswählt, muss sich fragen, ob ein Budget von 50 ms bei 480p auf aktueller Rechenzentrums-Hardware erreichbar ist (arXiv).
Das Profiling weist auf Decodierung und Cache-Updates
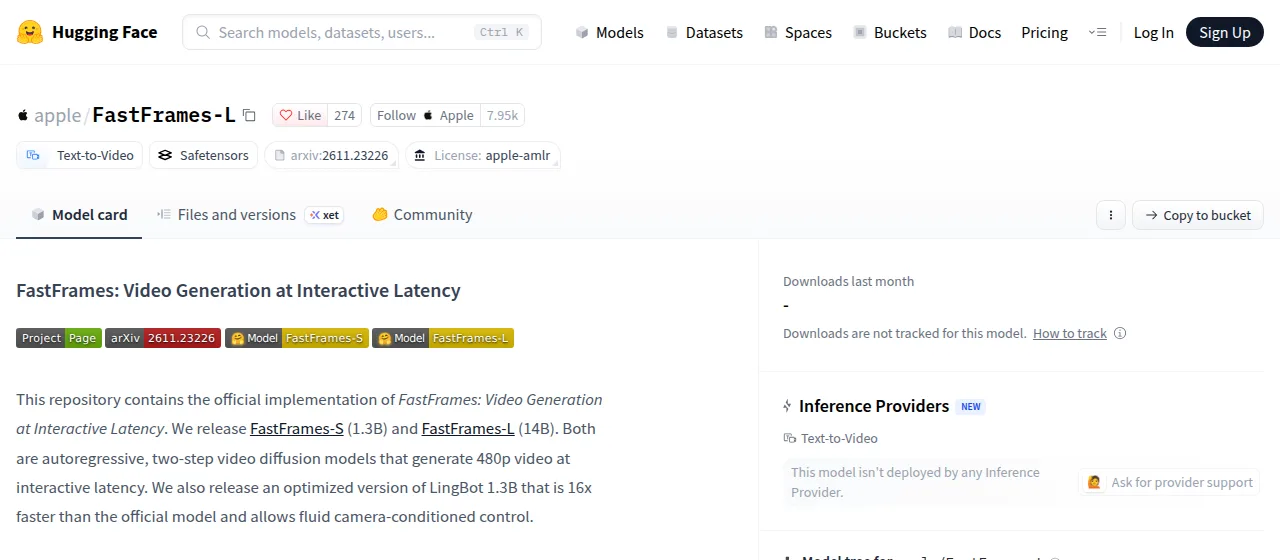
Das Paper geht von einem Profiling-Ergebnis aus: Laut den Autoren machen VAE-Decodierung und KV-Cache-Updates in State-of-the-Art-Modellen über die Hälfte der End-to-End-Inferenzlatenz aus. Diese Einordnung erklärt, warum die Arbeit die gesamte Pipeline angeht und nicht nur die Denoising-Schritte. Die veröffentlichten Modelle sind autoregressive Zwei-Schritt-Video-Diffusionsmodelle, die 480p-Video mit interaktiver Latenz erzeugen, in zwei Größen: FastFrames-S mit 1,3B und FastFrames-L mit 14B (huggingface.co).
Latenz bei 480p und 720p
Das Paper nennt für FastFrames-S 36 ms bei 480p und 127 ms bei 720p, gemessen auf einer B200. FastFrames-L, das 14B-Modell, braucht 45 ms bei 480p und 116 ms bei 720p, verteilt auf 8 B200-GPUs. Die Legende von Table 1 definiert das interaktive Ziel als 50 ms oder weniger und Latenz im Sub-Sekunden-Bereich als Werte zwischen 50 und 1.000 ms; FastFrames-S mit 36 ms und FastFrames-L auf 8 GPUs mit 45 ms erreichen also das Ziel bei 480p, während FastFrames-S mit 127 ms bei 720p im Sub-Sekunden-Bereich liegt. Das größere Modell braucht für seine Werte 8 GPUs, daher sind seine 116 ms bei 720p keine Single-Card-Zahl.
Wie Table 1 die Baselines einordnet
| Tabellenblock | Modell | Größe (B) | Latenz (ms) ↓ | Quellseite |
|---|---|---|---|---|
| Bidirectional Video Models | Wan2.1 | 1.3 | 30,444 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | Wan2.2 | 14.3 | 117,734 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | MiniMax-H3 | 33.1 | 38,454 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | HunyuanVideo1.5 | 8.3 | 1,555,508 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | LTX2.5 | 19.0 | 11,264 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | Helios Distilled | 14.3 | 2,544 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | Krea-Realtime | 14.3 | 1,675 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | LongLive2.0 | 5.0 | 505 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | CausVid | 1.3 | 662 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | Causal Forcing++ | 1.3 | 272 | https://arxiv.org/html/2611.23226 |
Laut der Legende von Table 1 erhält jede Methode dieselben Prompts und Seeds, läuft auf einer B200, sofern nicht anders angegeben, und wird bei etwa 480p mit ihren offiziell unterstützten Dimensionen bewertet. Bei den bidirektionalen Modellen braucht Wan2.1 mit 1,3 B 30.444 ms und LTX2.5 mit 19,0 B 11.264 ms. Bei den autoregressiven Modellen braucht LongLive2.0 mit 5,0 B 505 ms und CausVid mit 1,3 B 662 ms. Die bidirektionalen Zeilen reichen von 11.264 ms für LTX2.5 bis 1.555.508 ms für HunyuanVideo1.5, weit entfernt von einem Ziel von 50 ms; für den interaktiven Einsatz zählt daher der Vergleich mit dem autoregressiven Block. Selbst dort ist die schnellste Baseline des Papers Causal Forcing++ mit 272 ms, was im Sub-Sekunden-Bereich liegt, nach der Definition der Legende aber nicht interaktiv ist; LongLive2.0 mit 5,0 B braucht 505 ms, Krea-Realtime mit 14,3 B 1.675 ms und Helios Distilled mit 14,3 B 2.544 ms. Die 36 ms von FastFrames-S liegen unter jeder Baseline-Latenz in den hier aufgeführten Zeilen. Die Größe allein erklärt die Streuung nicht: Wan2.2 mit 14,3 B braucht 117.734 ms, Krea-Realtime mit denselben 14,3 B dagegen 1.675 ms.
Lizenzbedingungen und die Wahl zwischen den beiden Größen
Die Hugging-Face-Modellkarte von FastFrames-L deklariert die Lizenz apple-amlr, und das Repository besagt, dass der Code und die Gewichte von LingBot-World v2 ihrer Upstream-Lizenz CC BY-NC-SA 4.0 folgen, während der gesamte übrige FastFrames-Code unter der Apple Sample Code License steht; wer die Gewichte verwenden will, sollte diese Bedingungen daher zuerst lesen (Hugging Face). Zusammen gelesen bedeuten die Lizenzzeile der Modellkarte und die Latenzzahlen des Papers, dass dieselbe Veröffentlichung sowohl die Nutzungsbedingungen als auch die Geschwindigkeitsangaben enthält, die ein Team abwägen würde. Ein Team, das ein 1,3B-Modell auf einer B200 gegen ein 14B-Modell auf 8 B200-GPUs abwägt, sieht 36 ms gegen 45 ms bei 480p und 127 ms gegen 116 ms bei 720p. Nach diesen Zahlen erreicht das kleinere Modell das Ziel von 50 ms bereits auf einer Karte, während das größere dafür 8 braucht, um eine ähnliche Latenz zu erreichen.
Wie wir das erstellt haben
Veröffentlichte ErgebnisseTable 1 des Papers: Quantitativer Vergleich von End-to-End-Latenz und VBench-Werten
Zeilen aus Table 1 des Papers (arXiv-HTML-Version), von unserem Code Zelle für Zelle übernommen. Es sind die eigenen Zahlen der Autoren, kein unabhängiger Test. Die erste Spalte nennt den Tabellenblock der Zeile. Die Tabelle hat 6 Spalten; 3 sind gezeigt, nämlich jede Spalte mit einer im Artikel genannten Zahl oder Messgröße. Nicht gezeigt: VBench ↑ (3 Spalten). Zeilen: 10 von 16, mit jeder Zeile, deren Wert der Artikel nennt oder die er erwähnt; nicht gezeigt: Zeilen 6, 11, 13, 14, 15, 16. Von 2 Blöcken teilweise gezeigt: Autoregressive Video Models (5 von 11 Zeilen).
Quellen
Die Quellen, aus denen dieser Artikel geschrieben wurde. Die Links öffnen die Originalseite.
- arXivFastFrames: Video Generation at Interactive Latencyarxiv.org
- huggingface.coFastFrames: Video Generation at Interactive Latencyhuggingface.co
- arXivFastFrames: Video Generation at Interactive Latencyarxiv.org
- Hugging FaceLicence declared in the front matter of the model card apple/FastFrames-L on Hugging Facehuggingface.co