FastFrames, un paper su arXiv, presenta una famiglia di modelli di video diffusion autoregressivi che, secondo gli autori, raggiungono una latenza interattiva senza perdita di qualità (arXiv). Il modello più piccolo, da 1,3B, genera un frame in 36 ms, ovvero 28 risposte al secondo, su una sola GPU B200, e secondo il paper la sua qualità eguaglia quella di un modello allo stato dell’arte quasi 8x più lento. Per chi deve scegliere un modello per il video in tempo reale, la domanda diventa se un budget di 50 ms a 480p sia raggiungibile con l’hardware attuale dei datacenter (arXiv).
Il profiling indica decodifica e aggiornamenti della cache
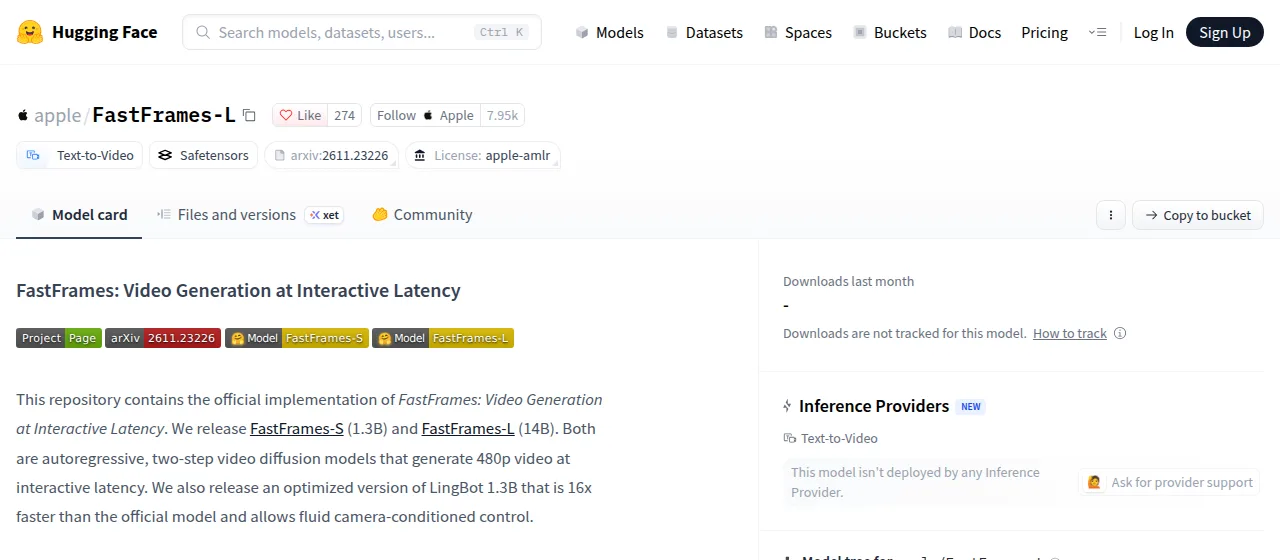
Il paper parte da un risultato di profiling: secondo gli autori, la decodifica VAE e gli aggiornamenti della KV cache rappresentano oltre la metà della latenza di inferenza end-to-end nei modelli allo stato dell’arte. Questa impostazione spiega perché il lavoro punti all’intera pipeline e non solo ai passi di denoising. I modelli rilasciati sono modelli di video diffusion autoregressivi a due passi che generano video a 480p con latenza interattiva, in due dimensioni: FastFrames-S da 1,3B e FastFrames-L da 14B (huggingface.co).
Latenza a 480p e 720p
Il paper indica per FastFrames-S 36 ms a 480p e 127 ms a 720p, misurati su una B200. FastFrames-L, il modello da 14B, impiega 45 ms a 480p e 116 ms a 720p quando è distribuito su 8 GPU B200. La didascalia della Tabella 1 definisce l’obiettivo interattivo come 50 ms o meno e la latenza sub-secondo come compresa tra 50 e 1.000 ms, quindi FastFrames-S a 36 ms e FastFrames-L su 8 GPU a 45 ms rispettano l’obiettivo a 480p, mentre FastFrames-S a 127 ms a 720p rientra nella fascia sub-secondo. Il modello più grande richiede 8 GPU per i suoi valori, quindi i 116 ms a 720p non sono un dato su singola scheda.
Come la Tabella 1 classifica i baseline
| Blocco della tabella | Modello | Dimensione (B) | Latenza (ms) ↓ | Pagina della fonte |
|---|---|---|---|---|
| Bidirectional Video Models | Wan2.1 | 1.3 | 30,444 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | Wan2.2 | 14.3 | 117,734 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | MiniMax-H3 | 33.1 | 38,454 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | HunyuanVideo1.5 | 8.3 | 1,555,508 | https://arxiv.org/html/2611.23226 |
| Bidirectional Video Models | LTX2.5 | 19.0 | 11,264 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | Helios Distilled | 14.3 | 2,544 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | Krea-Realtime | 14.3 | 1,675 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | LongLive2.0 | 5.0 | 505 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | CausVid | 1.3 | 662 | https://arxiv.org/html/2611.23226 |
| Autoregressive Video Models | Causal Forcing++ | 1.3 | 272 | https://arxiv.org/html/2611.23226 |
La didascalia della Tabella 1 afferma che ogni metodo riceve gli stessi prompt e seed, gira su una sola B200 salvo diversa indicazione ed è valutato a circa 480p con le dimensioni ufficialmente supportate. Tra i modelli bidirezionali, Wan2.1 da 1,3 B impiega 30.444 ms e LTX2.5 da 19,0 B impiega 11.264 ms. Tra i modelli autoregressivi, LongLive2.0 da 5,0 B impiega 505 ms e CausVid da 1,3 B impiega 662 ms. Le righe bidirezionali vanno dagli 11.264 ms di LTX2.5 fino a 1.555.508 ms di HunyuanVideo1.5, lontanissimi da un obiettivo di 50 ms, quindi il confronto rilevante per l’uso interattivo è con il blocco autoregressivo. Anche lì, il baseline più veloce del paper è Causal Forcing++ con 272 ms, che è sub-secondo ma non interattivo secondo la definizione della didascalia, mentre LongLive2.0 da 5,0 B impiega 505 ms, Krea-Realtime da 14,3 B impiega 1.675 ms e Helios Distilled da 14,3 B impiega 2.544 ms. I 36 ms di FastFrames-S sono inferiori a ogni latenza dei baseline nelle righe qui elencate. La dimensione da sola non spiega la dispersione: Wan2.2 da 14,3 B impiega 117.734 ms, mentre Krea-Realtime, con gli stessi 14,3 B, impiega 1.675 ms.
Termini di licenza e scelta tra le due dimensioni
La model card su Hugging Face di FastFrames-L dichiara la licenza apple-amlr, e il repository indica che il codice e i pesi di LingBot-World v2 seguono la licenza originale CC BY-NC-SA 4.0, mentre tutto il resto del codice di FastFrames è sotto la Apple Sample Code License, quindi chi intende usare i pesi dovrebbe leggere prima questi termini (Hugging Face). Letti insieme, la riga di licenza della model card e i dati di latenza del paper indicano che la stessa release riporta sia le condizioni d’uso sia le dichiarazioni di velocità che un team prenderebbe in considerazione. Un team che confronta un modello da 1,3B su una B200 con uno da 14B su 8 GPU B200 vede 36 ms contro 45 ms a 480p e 127 ms contro 116 ms a 720p. Con questi numeri il modello più piccolo rispetta già l’obiettivo di 50 ms su una sola scheda, mentre quello più grande ne richiede 8 per ottenere una latenza simile.
Come l'abbiamo costruito
Risultati pubblicatiTabella 1 del paper: confronti quantitativi di latenza end-to-end e punteggi VBench
Righe della Tabella 1 del paper (versione HTML su arXiv), copiate cella per cella dal nostro codice. Sono dati degli autori, non un test indipendente. La prima colonna indica il blocco della tabella cui appartiene la riga. La tabella ha 6 colonne; ne mostriamo 3, con ogni colonna che contiene un dato citato dall'articolo o una misura da esso nominata. Non mostrata: VBench ↑ (3 colonne). Righe: 10 su 16, con ogni riga il cui valore è citato dall'articolo o che esso nomina; non mostrate: righe 6, 11, 13, 14, 15, 16. Dei 2 blocchi, uno è parziale: Autoregressive Video Models (5 righe su 11).
Fonti
Le fonti da cui è stato scritto questo articolo. I link aprono la pagina originale.
- arXivFastFrames: Video Generation at Interactive Latencyarxiv.org
- huggingface.coFastFrames: Video Generation at Interactive Latencyhuggingface.co
- arXivFastFrames: Video Generation at Interactive Latencyarxiv.org
- Hugging FaceLicence declared in the front matter of the model card apple/FastFrames-L on Hugging Facehuggingface.co