Die Autoren von PhysResponse, einem arXiv-Benchmark für Videogeneratoren, berichten, dass bei zehn image-to-video-Modellen die besten Parameterfehler noch immer mehr als zehnmal so hoch sind wie bei physikalisch korrekten Videos (arXiv). Außerdem sagen sie, dass die Modelle selten beide Ergebnisse eines Übergangspaars reproduzieren und dass gängige visuelle Metriken wie PSNR Fehler übersehen, die der Benchmark aufdeckt. Für alle, die ein Modell für physikalisch plausible Bewegung auswählen, deutet das Ergebnis darauf hin, dass Pixelähnlichkeitswerte ein schlechter Wegweiser sind.
Was der Benchmark misst
PhysResponse prüft laut Paper die Reaktionsfähigkeit auf physikalische Parameter auf zwei Ebenen. Die erste Ebene invertiert einen auf die Szene konditionierten Simulator und ermittelt Schwerkraft, Reibung und Anfangsgeschwindigkeit, die die erzeugte Bewegung tatsächlich zeigt. Die zweite Ebene bewertet Ereignisse nahe kritischer Übergänge. Die Idee ist, in eine physikalische Einstellung einzugreifen und zu prüfen, ob das erzeugte Video darauf reagiert, statt nur zu beurteilen, ob ein Clip plausibel aussieht.
Die Autoren evaluierten zehn Modelle auf Core100 mit vier Prompt-Formaten und Seed 0, was 4.000 erzeugte Videos ergab (arXiv). Zur Kalibrierung der Messung ließen sie Ground-Truth-Videos durch dieselbe Pipeline laufen; dabei zeigten sich Fehler von 3,6 % bei der Schwerkraft, 1,4 % bei der Reibung und 1,1 % bei der Geschwindigkeit. Diese Ground-Truth-Werte sind die Untergrenze, mit der die Fehler der Modelle verglichen werden, und auf sie bezieht sich der Unterschied um eine Größenordnung im Lead.
Visuelle Metriken belohnen Stillstand
| Modell | Visuelle und Bewegungskonsistenz: L2 err. ↓ | Visuelle und Bewegungskonsistenz: S-IoU ↑ | Visuelle und Bewegungskonsistenz: PSNR ↑ | Visuelle und Bewegungskonsistenz: SSIM ↑ | Quellseite |
|---|---|---|---|---|---|
| Condition frame repeated | 12.59% | 0.000 | 37.8 | 0.977 | https://arxiv.org/html/2611.24419 |
| CogVideoX-1.5 | 13.59% | 0.057 | 22.9 | 0.844 | https://arxiv.org/html/2611.24419 |
| Cosmos-Predict2 | 13.60% | 0.071 | 20.8 | 0.800 | https://arxiv.org/html/2611.24419 |
| Cosmos3-Nano | 17.40% | 0.153 | 29.7 | 0.935 | https://arxiv.org/html/2611.24419 |
| HunyuanVideo-1.5 | 14.90% | 0.200 | 27.4 | 0.927 | https://arxiv.org/html/2611.24419 |
| MiniMax-H3 | 13.93% | 0.290 | 27.7 | 0.853 | https://arxiv.org/html/2611.24419 |
| PhysAlign | 19.29% | 0.217 | 30.1 | 0.940 | https://arxiv.org/html/2611.24419 |
| PhysRVG | 12.94% | 0.049 | 30.3 | 0.926 | https://arxiv.org/html/2611.24419 |
| VideoGPA | 16.10% | 0.064 | 22.0 | 0.806 | https://arxiv.org/html/2611.24419 |
| Wan2.2-I2V-A14B | 17.16% | 0.099 | 21.0 | 0.702 | https://arxiv.org/html/2611.24419 |
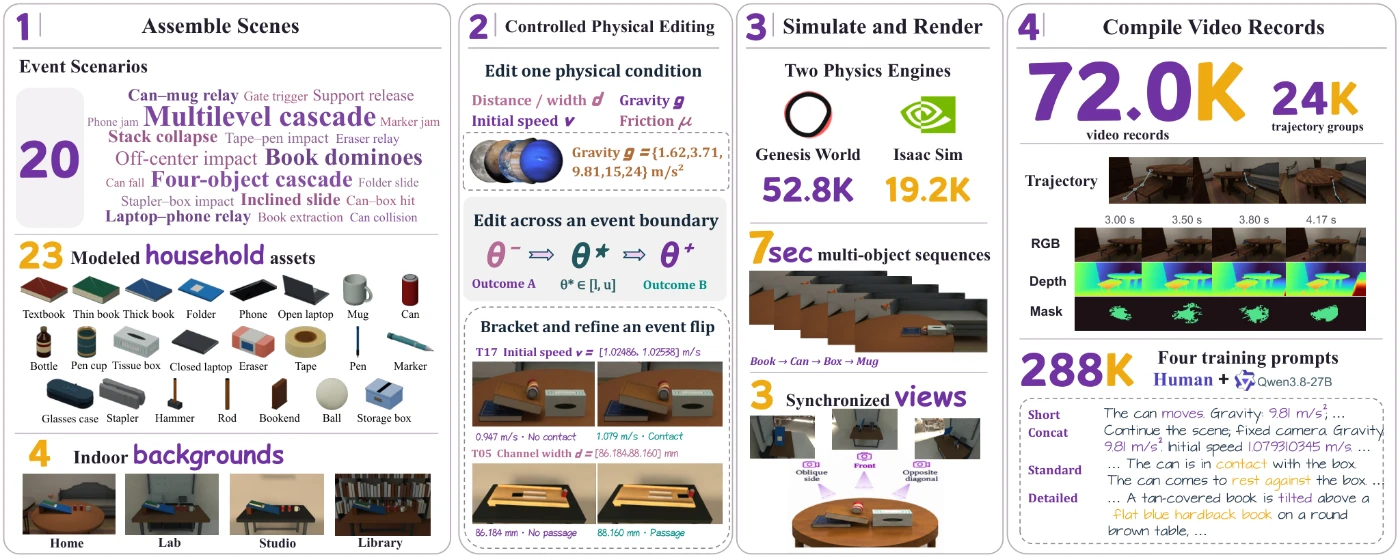
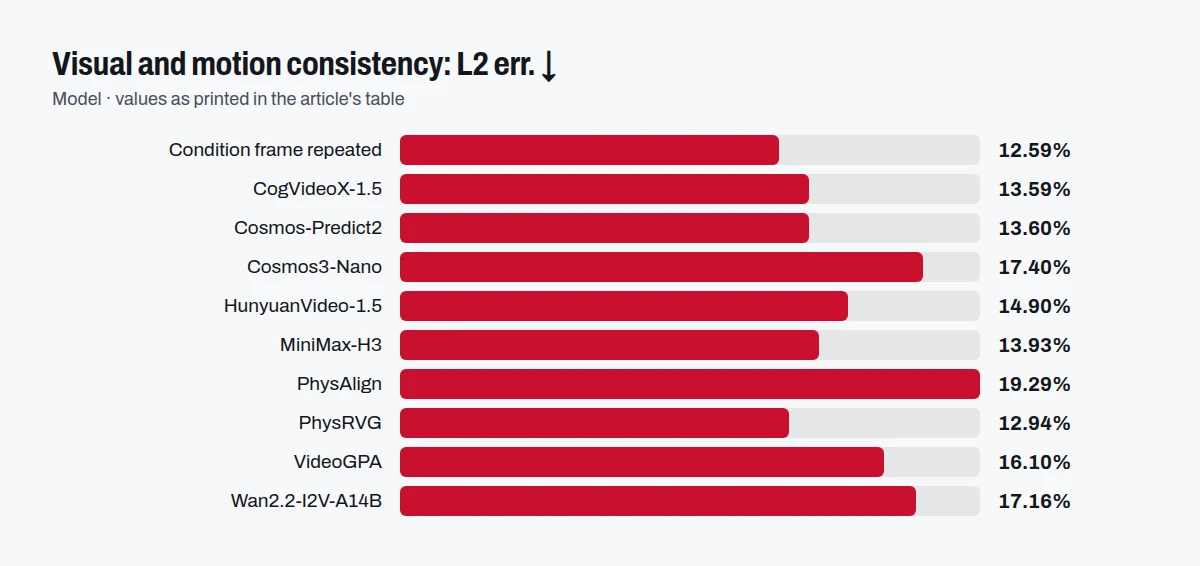
Tabelle 2 (a) des Papers fasst alle vier Prompt-Formate zusammen und berichtet die visuelle und Bewegungskonsistenz für jedes Modell, dazu eine Zeile, die einfach das Bedingungsbild wiederholt. Dieses wiederholte Bild hat einen L2-Fehler von 12,59 %, einen S-IoU von 0,000, einen PSNR von 37,8 und einen SSIM von 0,977. Die Autoren geben an, dass die Wiederholung des Bedingungsbilds jedes Modell bei PSNR, SSIM und L2-Fehler übertrifft. Die Tabelle zeigt, warum: Das wiederholte Bild hat einen S-IoU von 0,000, enthält also keine Bewegung, doch sein PSNR von 37,8 liegt über dem jedes Modells, wobei PhysAlign mit 30,1 und PhysRVG mit 30,3 unter den Modellen am höchsten liegen. Ein statischer Clip erzielt die beste Ähnlichkeit und verfehlt dabei die eigentliche Aufgabe, sodass diese Metriken schwache Bewegung belohnen.
Unter den Modellen hat PhysRVG mit 12,94 % den niedrigsten L2-Fehler, PhysAlign mit 19,29 % den höchsten. PhysAlign hat dennoch einen PSNR von 30,1 und einen SSIM von 0,940, was neben seinem schlechtesten L2-Wert steht. Die Metriken dieser Tabelle ordnen die Modelle nicht konsistent, ein weiterer Grund, jede einzelne von ihnen zu hinterfragen. MiniMax-H3 zeigt mit 0,290 den höchsten S-IoU unter den Modellen, während Cosmos3-Nano 0,153 bei einem L2-Fehler von 17,40 % erreicht.
Parametergenauigkeit und Ereignisergebnisse laufen auseinander
Die beiden Ebenen des Benchmarks erzählen nicht dieselbe Geschichte. Von 2.385 auf beiden Ebenen bewerteten Schwerkraft-Datensätzen verbinden 48 kleine Parameterfehler mit falschen Ereignisergebnissen, und 929 koppeln große Parameterfehler mit richtigen Ergebnissen. Ein Modell kann also aus dem falschen physikalischen Grund das richtige Ereignis treffen, und ein Benchmark, der nur Ergebnisse prüft, würde das nicht erkennen. Das passt zur Zusammenfassung der Autoren, dass die beiden Ebenen sich ergänzende Fehler aufdecken.
Auch die Rangfolgen hängen vom Maß ab. Laut Paper liegt Wan2.2-I2V-A14B bei PairAcc (30,7 % und 42,1 %) und bei VPSR (22,9 % und 34,6 %) auf Platz eins. Doch in Tabelle 2 (a) hat dieselbe Zeile von Wan2.2-I2V-A14B einen L2-Fehler von 17,16 % und einen SSIM von 0,702, den niedrigsten SSIM der gezeigten Zeilen. Ein Modell, das bei der Genauigkeit der Ereignispaare führt, kann bei der Pixelähnlichkeit schwach wirken, was für physikspezifische Maße spricht.
Umfang und Grenzen
Die Tabelle stammt von den Autoren selbst und ist kein unabhängiger Test, daher spiegeln die Werte deren Pipeline und Prompts wider. Das Paper beschränkt seinen Transfertest mit echten Videos auf WorldBench, und seine zurückgehaltenen Typen führen keine neuen Objekte oder Parameterbereiche ein. Praktiker sollten die Ergebnisse als Diagnose an kontrollierten Szenen lesen: Sie zeigen, wo aktuelle image-to-video-Modelle bei Schwerkraft, Reibung und Geschwindigkeit zurückbleiben, nicht aber, wie sie sich bei beliebigem Filmmaterial verhalten.
Was die gelesenen Quellen nicht angeben
Wir prüfen bei jeder Meldung sechs Angaben im vollständigen Text jeder Quelle. Die unter Quellen genannten Seiten nennen Hardwareanforderungen nicht.
Wie wir das erstellt haben
Veröffentlichte ErgebnisseTabelle 2 (a) des Papers: Kein Modell folgt der vorgegebenen Physik
Zeilen aus Tabelle 2 (a) des Papers (arXiv-HTML-Version), von unserem Code Zelle für Zelle kopiert; eine zweizeilige Kopfzeile erscheint als „Gruppe: Spalte“; ein leeres Namensfeld wiederholt den Namen darüber. Es sind die eigenen Zahlen der Autoren, kein unabhängiger Test. Die Tabelle hat 11 Spalten, 5 sind gezeigt. Nicht gezeigt: Kinematik (2 Spalten), effektiver Parameterfehler (3 Spalten), Human. Zeilen: die ersten 10 von 11.
Quellen
Die Quellen, aus denen dieser Artikel geschrieben wurde. Die Links öffnen die Originalseite.