Los autores de PhysResponse, un benchmark de arXiv para generadores de vídeo, informan de que, en diez modelos image-to-video, los mejores errores de parámetros siguen siendo más de diez veces los de los vídeos físicamente correctos (arXiv). También afirman que los modelos rara vez reproducen los dos resultados de un par de transición y que métricas visuales habituales como el PSNR no detectan fallos que el benchmark pone de manifiesto. Para quien elija un modelo con movimiento físicamente plausible, el resultado sugiere que las puntuaciones de similitud de píxeles son una mala guía.
Qué mide el benchmark
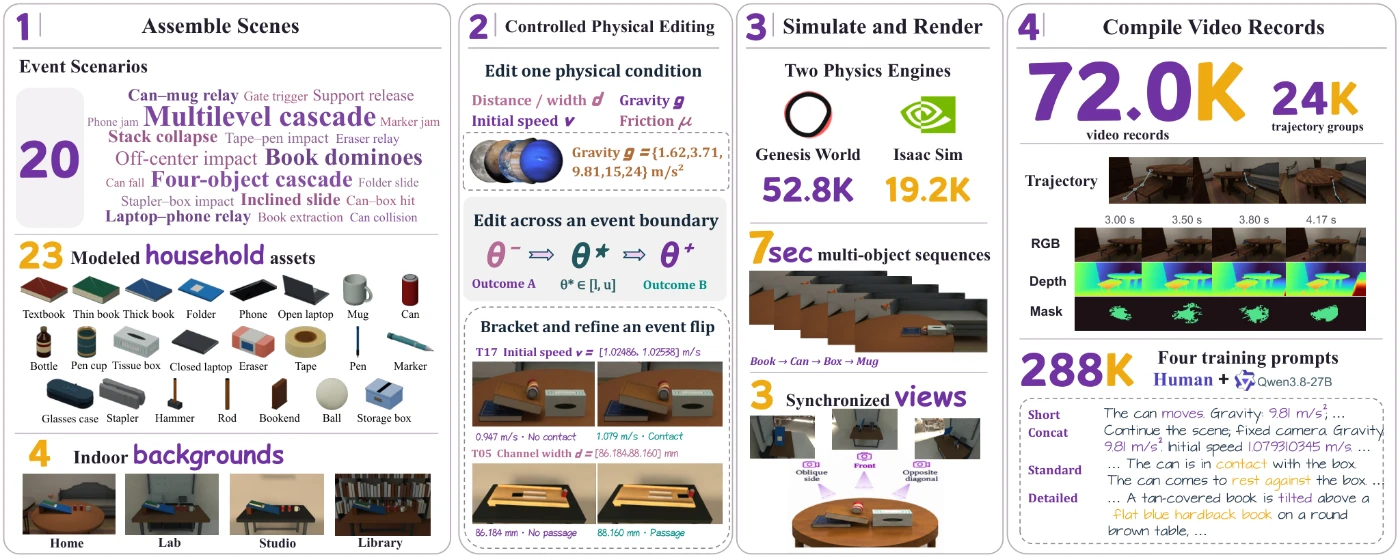
Según el artículo, PhysResponse prueba la sensibilidad a los parámetros físicos en dos niveles. El primer nivel invierte un simulador condicionado por la escena y recupera la gravedad, la fricción y la velocidad inicial que muestra en la práctica el movimiento generado. El segundo nivel evalúa eventos cercanos a transiciones críticas. La idea es intervenir sobre un ajuste físico y comprobar si el vídeo generado responde a él, en lugar de juzgar si un clip simplemente parece plausible.
Los autores evaluaron diez modelos en Core100 con cuatro formatos de prompt y la semilla 0, lo que produjo 4.000 vídeos generados (arXiv). Para calibrar la medición, pasaron vídeos de referencia por el mismo proceso, que mostraron errores del 3,6 % en gravedad, del 1,4 % en fricción y del 1,1 % en velocidad. Esas cifras de referencia son el mínimo con el que se comparan los errores de los modelos, y a ellas se refiere la diferencia de un orden de magnitud mencionada al inicio.
Las métricas visuales premian quedarse quieto
| Modelo | Consistencia visual y de movimiento: error L2 ↓ | Consistencia visual y de movimiento: S-IoU ↑ | Consistencia visual y de movimiento: PSNR ↑ | Consistencia visual y de movimiento: SSIM ↑ | Página de origen |
|---|---|---|---|---|---|
| Condition frame repeated | 12.59% | 0.000 | 37.8 | 0.977 | https://arxiv.org/html/2611.24419 |
| CogVideoX-1.5 | 13.59% | 0.057 | 22.9 | 0.844 | https://arxiv.org/html/2611.24419 |
| Cosmos-Predict2 | 13.60% | 0.071 | 20.8 | 0.800 | https://arxiv.org/html/2611.24419 |
| Cosmos3-Nano | 17.40% | 0.153 | 29.7 | 0.935 | https://arxiv.org/html/2611.24419 |
| HunyuanVideo-1.5 | 14.90% | 0.200 | 27.4 | 0.927 | https://arxiv.org/html/2611.24419 |
| MiniMax-H3 | 13.93% | 0.290 | 27.7 | 0.853 | https://arxiv.org/html/2611.24419 |
| PhysAlign | 19.29% | 0.217 | 30.1 | 0.940 | https://arxiv.org/html/2611.24419 |
| PhysRVG | 12.94% | 0.049 | 30.3 | 0.926 | https://arxiv.org/html/2611.24419 |
| VideoGPA | 16.10% | 0.064 | 22.0 | 0.806 | https://arxiv.org/html/2611.24419 |
| Wan2.2-I2V-A14B | 17.16% | 0.099 | 21.0 | 0.702 | https://arxiv.org/html/2611.24419 |
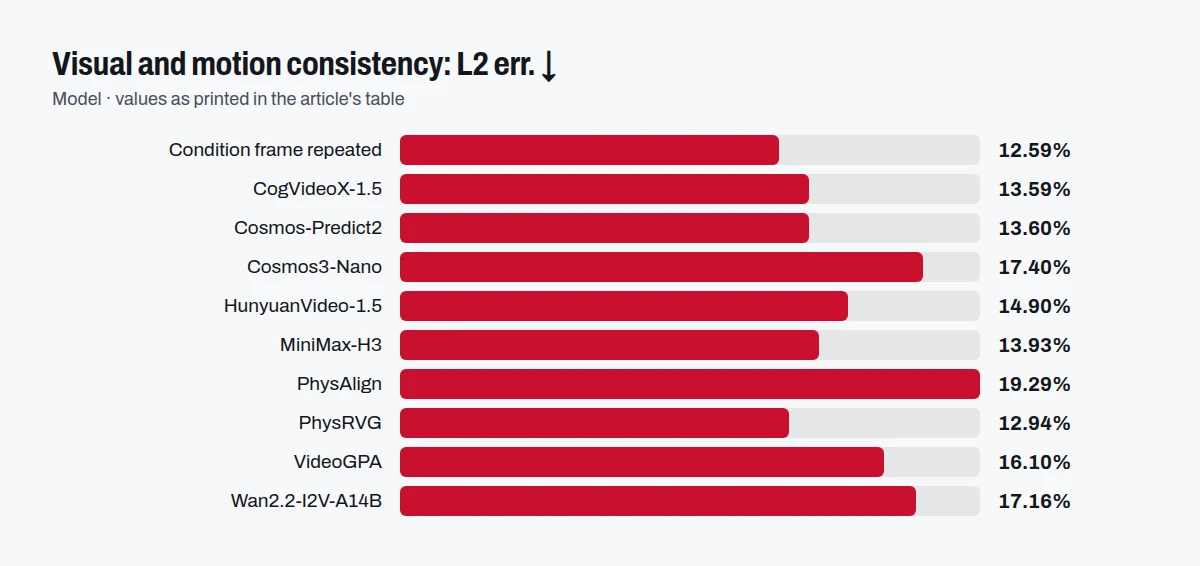
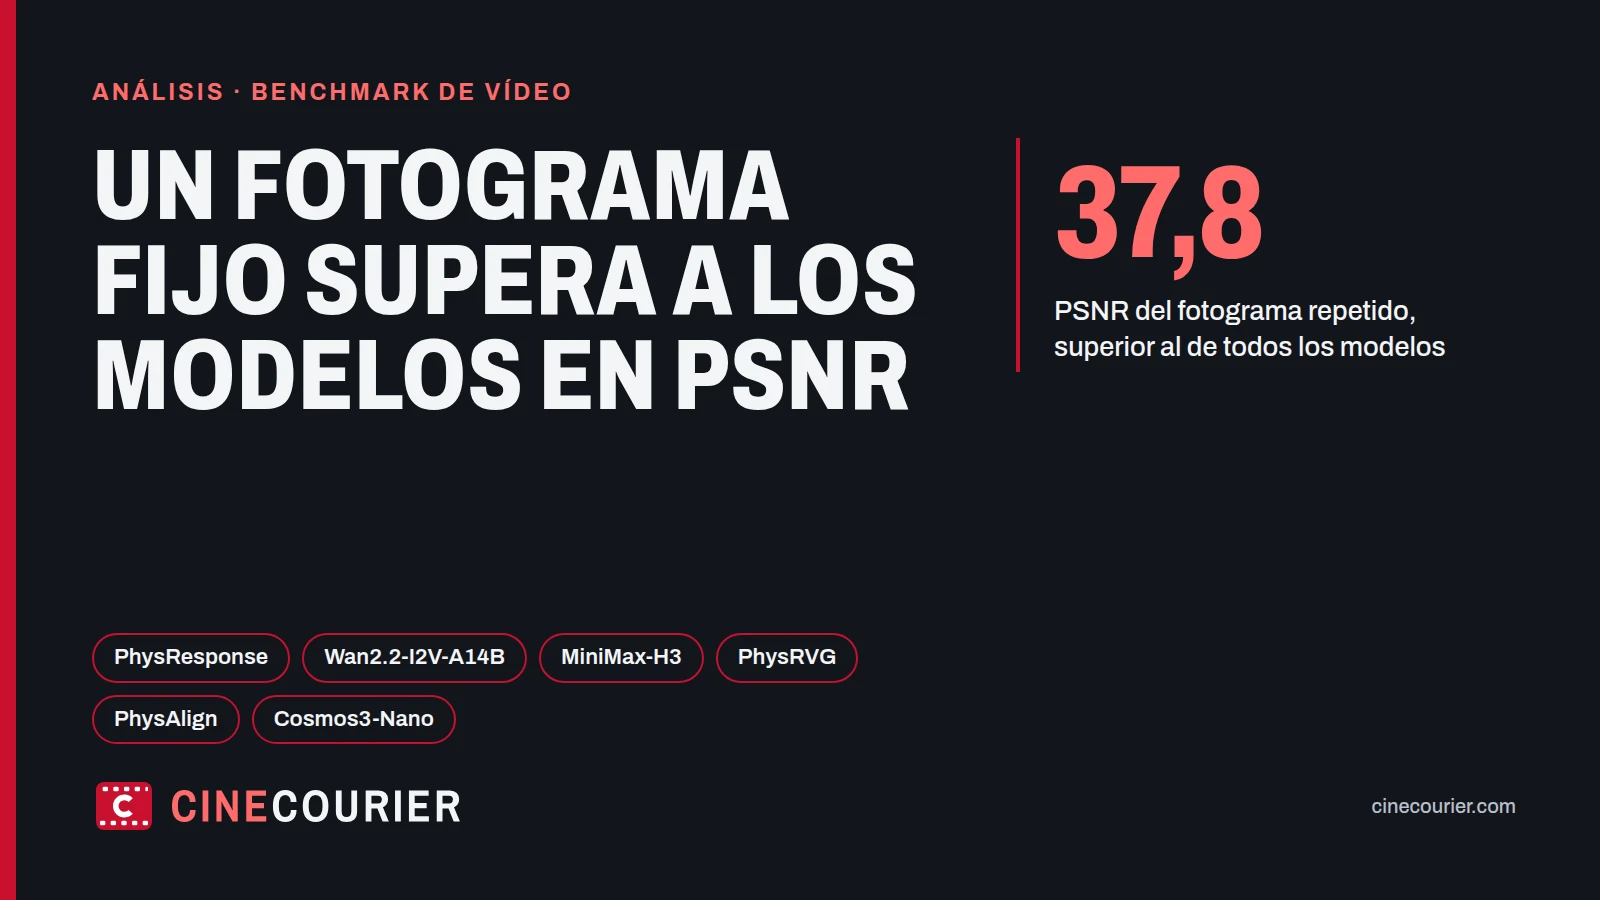
La tabla 2 (a) del artículo agrupa los cuatro formatos de prompt e informa de la consistencia visual y de movimiento de cada modelo, con una fila que simplemente repite el fotograma de condición. Ese fotograma repetido tiene un error L2 del 12,59 %, un S-IoU de 0,000, un PSNR de 37,8 y un SSIM de 0,977. Los autores afirman que repetir el fotograma de condición supera a todos los modelos en PSNR, SSIM y error L2. La tabla muestra por qué: el fotograma repetido tiene un S-IoU de 0,000, así que no contiene movimiento, pero su PSNR de 37,8 supera el de todos los modelos, con PhysAlign en 30,1 y PhysRVG en 30,3 como los más altos entre los modelos. Un clip estático obtiene la mejor puntuación de similitud mientras fracasa en la tarea real, de modo que estas métricas premian el movimiento débil.
Entre los modelos, PhysRVG tiene el menor error L2, con un 12,94 %, mientras que PhysAlign tiene el mayor, con un 19,29 %. Aun así, PhysAlign tiene un PSNR de 30,1 y un SSIM de 0,940, lo que convive con su peor cifra de L2. Las métricas de esta tabla no ordenan los modelos de forma coherente, otra razón para dudar de cualquiera de ellas por separado. MiniMax-H3 muestra el mayor S-IoU de los modelos, 0,290, mientras que Cosmos3-Nano llega a 0,153 con un error L2 del 17,40 %.
La precisión de los parámetros y los resultados de los eventos divergen
Los dos niveles del benchmark no cuentan la misma historia. De 2.385 registros de gravedad puntuados en ambos niveles, 48 combinan errores de parámetros pequeños con resultados de evento erróneos, y 929 asocian errores de parámetros grandes con resultados correctos. Por tanto, un modelo puede acertar el evento por una razón física equivocada, y un benchmark que solo compruebe los resultados no lo vería. Esto concuerda con el resumen de los autores de que los dos niveles revelan fallos complementarios.
Las clasificaciones también dependen de la medida. El artículo dice que Wan2.2-I2V-A14B ocupa el primer puesto en PairAcc (30,7 % y 42,1 %) y en VPSR (22,9 % y 34,6 %). Sin embargo, en la tabla 2 (a) esa misma fila de Wan2.2-I2V-A14B tiene un error L2 del 17,16 % y un SSIM de 0,702, el SSIM más bajo de las filas mostradas. Un modelo que lidera en precisión de pares de eventos puede parecer débil en similitud de píxeles, lo que respalda la necesidad de medidas específicas de física.
Alcance y límites
La tabla es de los propios autores y no una prueba independiente, por lo que las cifras reflejan su proceso y sus prompts. El artículo limita su prueba de transferencia a vídeo real a WorldBench, y sus tipos reservados no añaden objetos ni rangos de parámetros nuevos. Los profesionales deben leer los resultados como un diagnóstico en escenas controladas: muestran dónde se quedan cortos los modelos image-to-video actuales en gravedad, fricción y velocidad, no cómo se comportan con metraje arbitrario.
Lo que no indican las fuentes que leímos
Comprobamos seis datos en cada historia en el texto completo de cada fuente. Las páginas de la lista de fuentes no indican requisitos de hardware.
Cómo lo hemos hecho
Resultados publicadosTabla 2 (a) del artículo: ningún modelo sigue la física indicada en el prompt
Filas de la tabla 2 (a) del artículo (versión HTML de arXiv), copiadas celda a celda por nuestro código; una cabecera de dos filas se muestra como «grupo: columna»; un nombre vacío repite el de arriba. Son cifras de los propios autores, no una prueba independiente. La tabla tiene 11 columnas; se muestran 5. No se muestran: Cinemática (2 columnas), Error de parámetros efectivo (3 columnas), Humano. Filas: las 10 primeras de 11.
Fuentes
Las fuentes a partir de las que se escribió este artículo. Los enlaces abren la página original.