Gli autori di PhysResponse, un benchmark arXiv per i generatori di video, riportano che su dieci modelli image-to-video i migliori errori sui parametri sono ancora più di dieci volte quelli dei video fisicamente corretti (arXiv). Aggiungono che i modelli riproducono di rado entrambi gli esiti di una coppia di transizione e che metriche visive comuni come il PSNR non rilevano fallimenti che il benchmark mette in luce. Per chi sceglie un modello per un movimento fisicamente plausibile, il risultato suggerisce che i punteggi di similarità dei pixel siano una guida poco affidabile.
Che cosa misura il benchmark
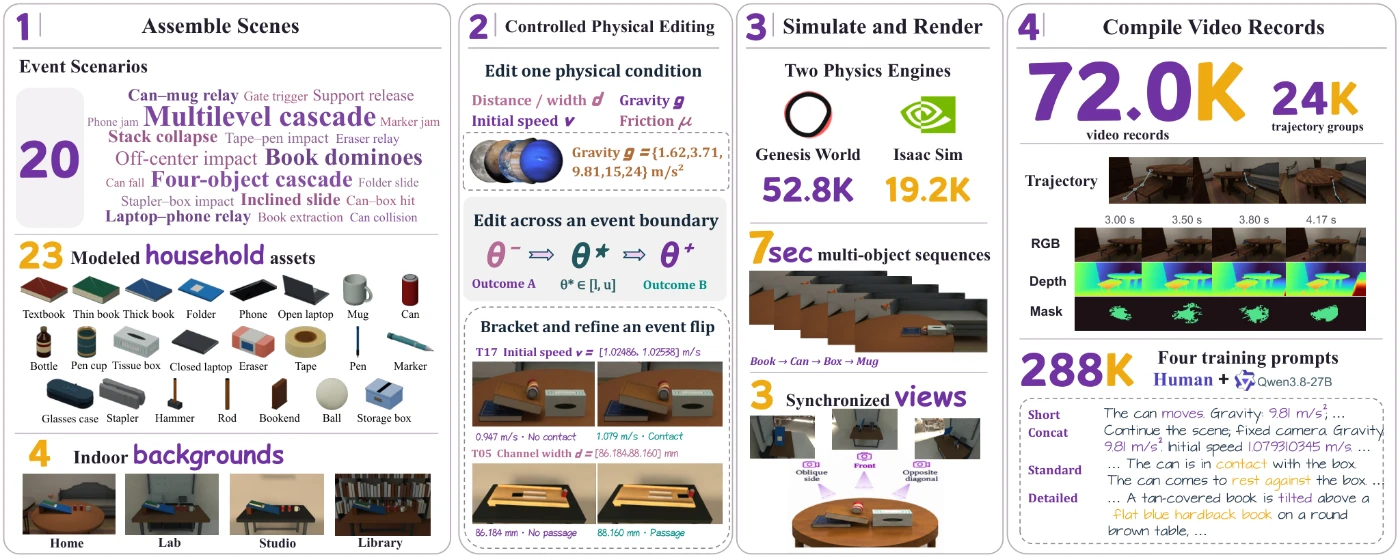
Secondo il paper, PhysResponse verifica la reattività ai parametri fisici su due livelli. Il primo livello inverte un simulatore condizionato sulla scena, ricavando la gravità, l’attrito e la velocità iniziale che il movimento generato mostra di fatto. Il secondo livello valuta gli eventi in prossimità di transizioni critiche. L’idea è intervenire su un’impostazione fisica e verificare se il video generato reagisce, invece di giudicare se una clip appaia semplicemente plausibile.
Gli autori hanno valutato dieci modelli su Core100 con quattro formati di prompt e seed 0, ottenendo 4.000 video generati (arXiv). Per calibrare la misura, hanno fatto passare video ground-truth nella stessa pipeline, che ha mostrato errori del 3,6% per la gravità, dell’1,4% per l’attrito e dell’1,1% per la velocità. Questi valori ground-truth sono il limite minimo con cui si confrontano gli errori dei modelli e sono ciò a cui si riferisce il divario di un ordine di grandezza citato nell’introduzione.
Le metriche visive premiano l’immobilità
| Modello | Coerenza visiva e del movimento: errore L2 ↓ | Coerenza visiva e del movimento: S-IoU ↑ | Coerenza visiva e del movimento: PSNR ↑ | Coerenza visiva e del movimento: SSIM ↑ | Pagina della fonte |
|---|---|---|---|---|---|
| Condition frame repeated | 12.59% | 0.000 | 37.8 | 0.977 | https://arxiv.org/html/2611.24419 |
| CogVideoX-1.5 | 13.59% | 0.057 | 22.9 | 0.844 | https://arxiv.org/html/2611.24419 |
| Cosmos-Predict2 | 13.60% | 0.071 | 20.8 | 0.800 | https://arxiv.org/html/2611.24419 |
| Cosmos3-Nano | 17.40% | 0.153 | 29.7 | 0.935 | https://arxiv.org/html/2611.24419 |
| HunyuanVideo-1.5 | 14.90% | 0.200 | 27.4 | 0.927 | https://arxiv.org/html/2611.24419 |
| MiniMax-H3 | 13.93% | 0.290 | 27.7 | 0.853 | https://arxiv.org/html/2611.24419 |
| PhysAlign | 19.29% | 0.217 | 30.1 | 0.940 | https://arxiv.org/html/2611.24419 |
| PhysRVG | 12.94% | 0.049 | 30.3 | 0.926 | https://arxiv.org/html/2611.24419 |
| VideoGPA | 16.10% | 0.064 | 22.0 | 0.806 | https://arxiv.org/html/2611.24419 |
| Wan2.2-I2V-A14B | 17.16% | 0.099 | 21.0 | 0.702 | https://arxiv.org/html/2611.24419 |
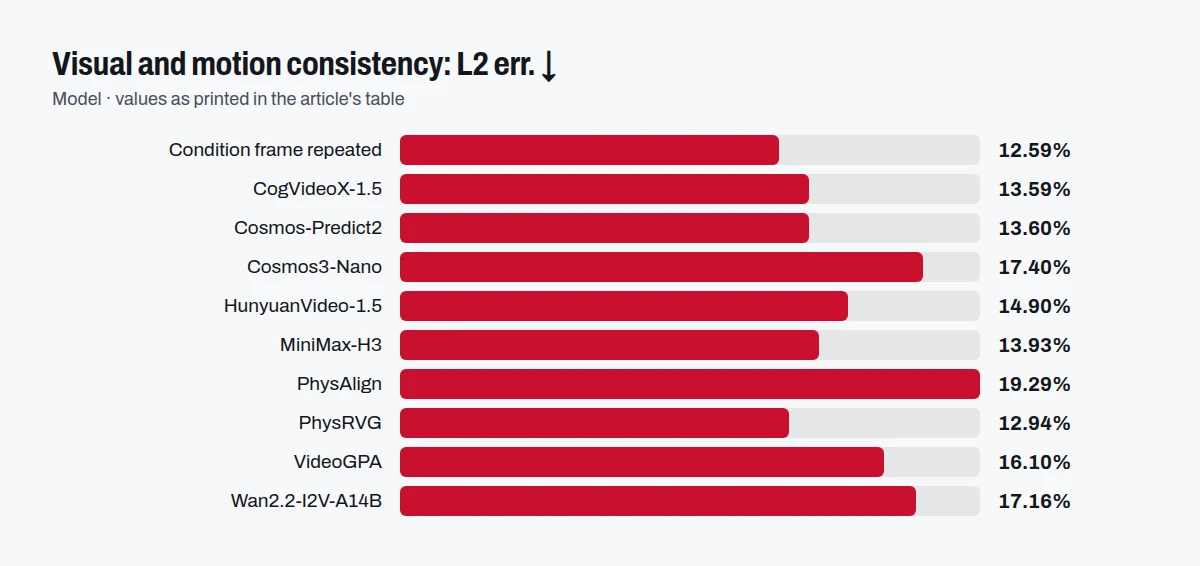
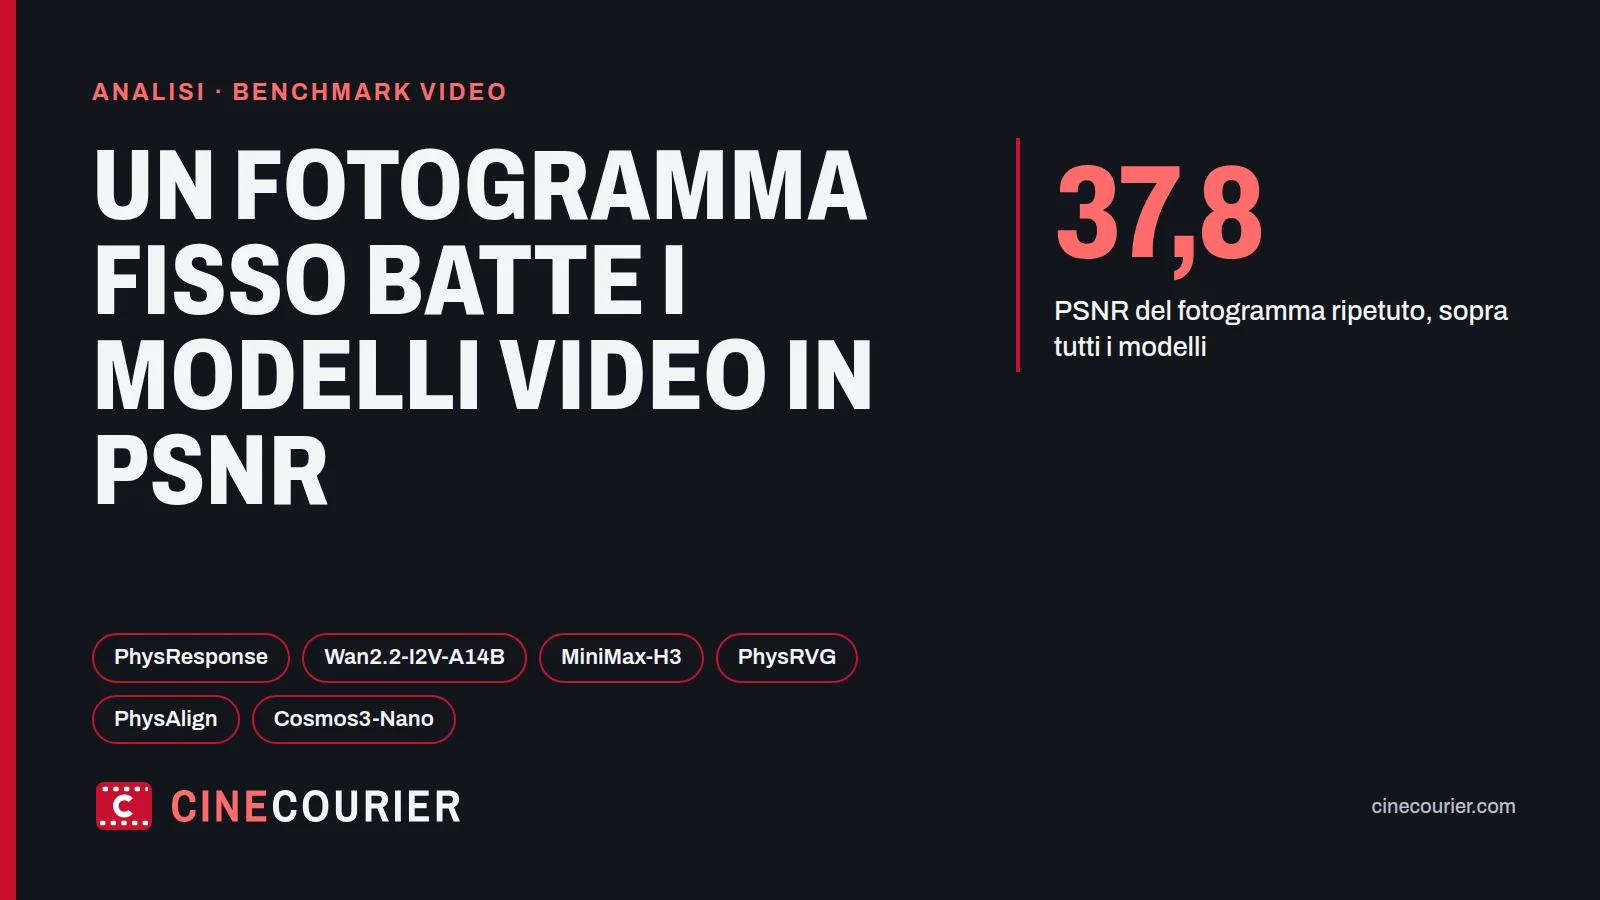
La Tabella 2 (a) del paper aggrega tutti e quattro i formati di prompt e riporta la coerenza visiva e del movimento di ciascun modello, con una riga che si limita a ripetere il fotogramma di condizione. Quel fotogramma ripetuto ha un errore L2 del 12,59%, un S-IoU di 0,000, un PSNR di 37,8 e un SSIM di 0,977. Gli autori affermano che ripetere il fotogramma di condizione batte ogni modello in PSNR, SSIM ed errore L2. La tabella lo spiega: il fotogramma ripetuto ha un S-IoU di 0,000, quindi non contiene movimento, eppure il suo PSNR di 37,8 supera quello di ogni modello, con PhysAlign a 30,1 e PhysRVG a 30,3 i più alti tra i modelli. Una clip statica ottiene il punteggio migliore in similarità pur fallendo il compito reale, quindi queste metriche premiano il movimento debole.
Tra i modelli, PhysRVG ha l’errore L2 più basso, 12,94%, mentre PhysAlign ha il più alto, 19,29%. PhysAlign ha comunque un PSNR di 30,1 e un SSIM di 0,940, che convivono con il suo peggior valore L2. Le metriche di questa tabella non ordinano i modelli in modo coerente, un ulteriore motivo per dubitare di ciascuna di esse. MiniMax-H3 mostra il più alto S-IoU tra i modelli, 0,290, mentre Cosmos3-Nano raggiunge 0,153 con un errore L2 del 17,40%.
Precisione dei parametri ed esiti degli eventi divergono
I due livelli del benchmark non raccontano la stessa storia. Su 2.385 record di gravità valutati a entrambi i livelli, 48 combinano piccoli errori sui parametri con risultati sbagliati sugli eventi e 929 abbinano grandi errori sui parametri a risultati corretti. Un modello può quindi arrivare all’evento giusto per la ragione fisica sbagliata, e un benchmark che controlla solo gli esiti non lo vedrebbe. Ciò è coerente con la sintesi degli autori, secondo cui i due livelli rivelano fallimenti complementari.
Anche le classifiche dipendono dalla misura. Il paper afferma che Wan2.2-I2V-A14B è primo in PairAcc (30,7% e 42,1%) e in VPSR (22,9% e 34,6%). Eppure nella Tabella 2 (a) la stessa riga di Wan2.2-I2V-A14B ha un errore L2 del 17,16% e un SSIM di 0,702, il più basso tra le righe mostrate. Un modello che primeggia per accuratezza sulle coppie di eventi può apparire debole nella similarità dei pixel, il che sostiene la necessità di misure specifiche per la fisica.
Ambito e limiti
La tabella è degli autori e non un test indipendente, quindi i valori riflettono la loro pipeline e i loro prompt. Il paper limita a WorldBench il test di trasferimento su video reali, e i suoi tipi esclusi dall’addestramento non aggiungono nuovi oggetti né intervalli di parametri. I professionisti dovrebbero leggere i risultati come una diagnosi su scene controllate: mostrano dove gli attuali modelli image-to-video sono carenti su gravità, attrito e velocità, non come si comportano su filmati arbitrari.
Cosa non indicano le fonti che abbiamo letto
Controlliamo sei dati in ogni storia nel testo completo di ogni fonte. Le pagine elencate tra le fonti non indicano requisiti hardware.
Come l'abbiamo costruito
Risultati pubblicatiTabella 2 (a) del paper: nessun modello segue la fisica indicata nel prompt
Righe della Tabella 2 (a) del paper (versione HTML di arXiv), copiate cella per cella dal nostro codice; un'intestazione su due righe appare come "gruppo: colonna"; un nome vuoto ripete quello sopra. Sono dati degli autori, non un test indipendente. La tabella ha 11 colonne; ne mostriamo 5. Non mostrate: Cinematica (2 colonne), Errore sui parametri effettivi (3 colonne), Human. Righe: le prime 10 su 11.
Fonti
Le fonti da cui è stato scritto questo articolo. I link aprono la pagina originale.