Les auteurs de PhysResponse, un benchmark arXiv pour les générateurs vidéo, indiquent que, sur dix modèles image-vers-vidéo, les meilleures erreurs de paramètres restent plus de dix fois supérieures à celles de vidéos physiquement correctes (arXiv). Ils affirment aussi que les modèles reproduisent rarement les deux issues d’une paire de transition, et que des métriques visuelles courantes comme le PSNR laissent passer des échecs que le benchmark met en évidence. Pour qui choisit un modèle pour un mouvement physiquement plausible, ce résultat suggère que les scores de similarité de pixels sont un mauvais guide.
Ce que mesure le benchmark
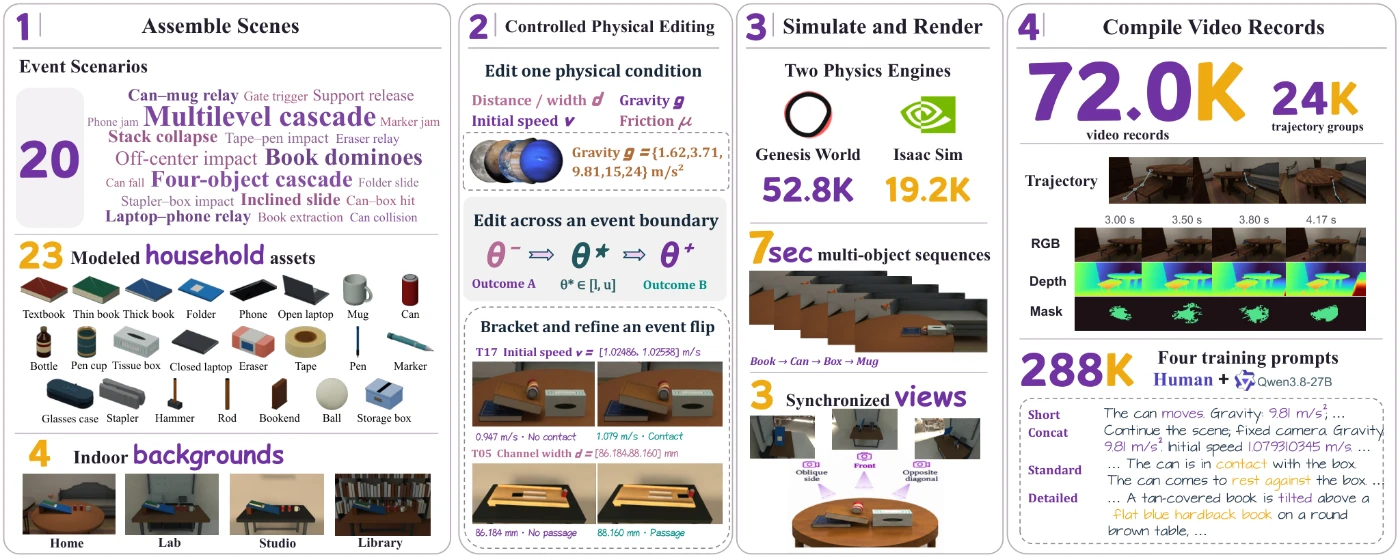
Selon l’article, PhysResponse teste la réactivité aux paramètres physiques à deux niveaux. Le premier niveau inverse un simulateur conditionné par la scène, ce qui permet de retrouver la gravité, le frottement et la vitesse initiale que le mouvement généré montre en pratique. Le second niveau évalue des événements proches de transitions critiques. L’idée est d’intervenir sur un réglage physique et de vérifier si la vidéo générée y réagit, au lieu de juger si un clip paraît simplement plausible.
Les auteurs ont évalué dix modèles sur Core100 avec quatre formats de prompt et la graine 0, ce qui a produit 4 000 vidéos générées (arXiv). Pour calibrer la mesure, ils ont fait passer des vidéos de référence dans le même pipeline, ce qui a donné des erreurs de 3,6 % pour la gravité, 1,4 % pour le frottement et 1,1 % pour la vitesse. Ces chiffres de référence sont le plancher auquel les erreurs des modèles sont comparées, et c’est à eux que renvoie l’écart d’un ordre de grandeur mentionné en introduction.
Les métriques visuelles récompensent l’immobilité
| Modèle | Cohérence visuelle et du mouvement : erreur L2 ↓ | Cohérence visuelle et du mouvement : S-IoU ↑ | Cohérence visuelle et du mouvement : PSNR ↑ | Cohérence visuelle et du mouvement : SSIM ↑ | Page source |
|---|---|---|---|---|---|
| Condition frame repeated | 12.59% | 0.000 | 37.8 | 0.977 | https://arxiv.org/html/2611.24419 |
| CogVideoX-1.5 | 13.59% | 0.057 | 22.9 | 0.844 | https://arxiv.org/html/2611.24419 |
| Cosmos-Predict2 | 13.60% | 0.071 | 20.8 | 0.800 | https://arxiv.org/html/2611.24419 |
| Cosmos3-Nano | 17.40% | 0.153 | 29.7 | 0.935 | https://arxiv.org/html/2611.24419 |
| HunyuanVideo-1.5 | 14.90% | 0.200 | 27.4 | 0.927 | https://arxiv.org/html/2611.24419 |
| MiniMax-H3 | 13.93% | 0.290 | 27.7 | 0.853 | https://arxiv.org/html/2611.24419 |
| PhysAlign | 19.29% | 0.217 | 30.1 | 0.940 | https://arxiv.org/html/2611.24419 |
| PhysRVG | 12.94% | 0.049 | 30.3 | 0.926 | https://arxiv.org/html/2611.24419 |
| VideoGPA | 16.10% | 0.064 | 22.0 | 0.806 | https://arxiv.org/html/2611.24419 |
| Wan2.2-I2V-A14B | 17.16% | 0.099 | 21.0 | 0.702 | https://arxiv.org/html/2611.24419 |
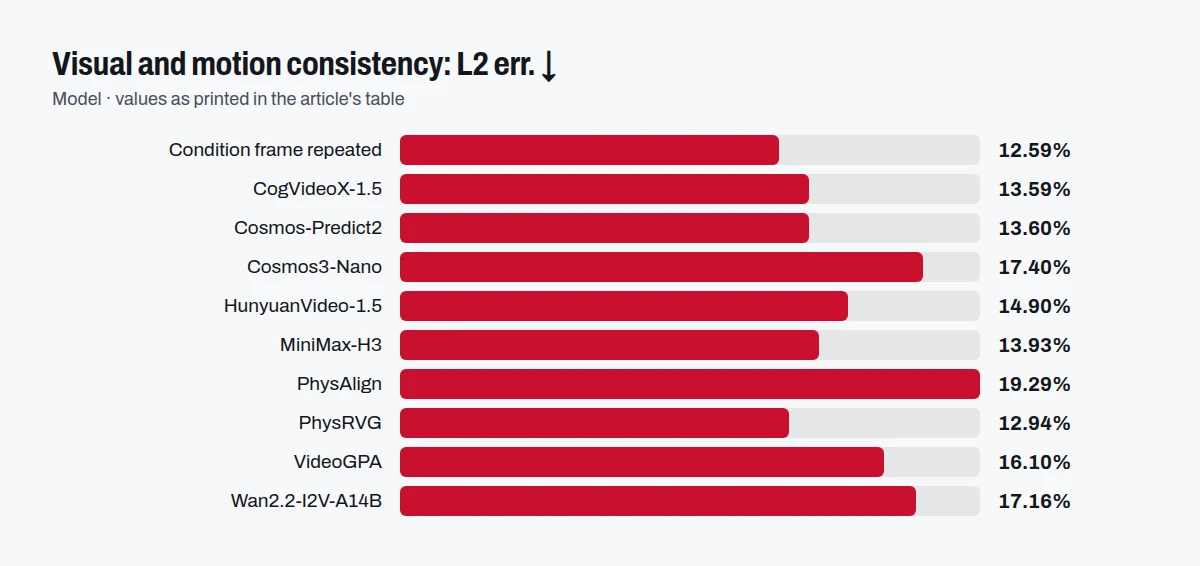
Le tableau 2 (a) de l’article regroupe les quatre formats de prompt et rapporte la cohérence visuelle et du mouvement de chaque modèle, avec une ligne qui se contente de répéter l’image de condition. Cette image répétée a une erreur L2 de 12,59 %, un S-IoU de 0,000, un PSNR de 37,8 et un SSIM de 0,977. Les auteurs indiquent que répéter l’image de condition fait mieux que tous les modèles en PSNR, SSIM et erreur L2. Le tableau montre pourquoi : l’image répétée a un S-IoU de 0,000, donc aucun mouvement, mais son PSNR de 37,8 dépasse celui de tous les modèles, PhysAlign à 30,1 et PhysRVG à 30,3 étant les plus élevés parmi les modèles. Un clip statique obtient le meilleur score de similarité tout en échouant à la tâche réelle : ces métriques récompensent donc les mouvements faibles.
Parmi les modèles, PhysRVG a l’erreur L2 la plus basse, à 12,94 %, tandis que PhysAlign a la plus élevée, à 19,29 %. PhysAlign affiche pourtant un PSNR de 30,1 et un SSIM de 0,940, ce qui cohabite avec son pire chiffre L2. Les métriques de ce tableau ne classent pas les modèles de façon cohérente, ce qui est une raison de plus de douter de chacune d’elles prise isolément. MiniMax-H3 présente le S-IoU le plus élevé des modèles, à 0,290, tandis que Cosmos3-Nano atteint 0,153 avec une erreur L2 de 17,40 %.
Précision des paramètres et issues des événements divergent
Les deux niveaux du benchmark ne racontent pas la même histoire. Sur 2 385 enregistrements de gravité notés aux deux niveaux, 48 associent de faibles erreurs de paramètres à de mauvais résultats d’événement, et 929 associent de fortes erreurs de paramètres à de bons résultats. Un modèle peut donc tomber sur le bon événement pour une mauvaise raison physique, et un benchmark qui ne vérifie que les issues ne le verrait pas. Cela concorde avec le résumé des auteurs, selon lequel les deux niveaux révèlent des échecs complémentaires.
Les classements dépendent aussi de la mesure. L’article indique que Wan2.2-I2V-A14B se classe premier en PairAcc (30,7 % et 42,1 %) et en VPSR (22,9 % et 34,6 %). Pourtant, dans le tableau 2 (a), la même ligne Wan2.2-I2V-A14B a une erreur L2 de 17,16 % et un SSIM de 0,702, le plus bas des lignes affichées. Un modèle en tête sur la précision des paires d’événements peut paraître faible en similarité de pixels, ce qui plaide pour des mesures propres à la physique.
Portée et limites
Le tableau est celui des auteurs et non un test indépendant : les chiffres reflètent donc leur pipeline et leurs prompts. L’article limite son test de transfert sur vidéos réelles à WorldBench, et ses types de test mis de côté n’ajoutent ni nouveaux objets ni nouvelles plages de paramètres. Les praticiens devraient lire les résultats comme un diagnostic sur des scènes contrôlées : ils montrent où les modèles image-vers-vidéo actuels sont insuffisants en gravité, frottement et vitesse, pas comment ils se comportent sur des images quelconques.
Absent des sources : configuration matérielle
Nous vérifions six informations pour chaque sujet dans le texte intégral de chaque source. Les pages citées en sources n’indiquent pas la configuration matérielle requise.
Comment nous l'avons construit
Résultats publiésTableau 2 (a) de l'article : aucun modèle ne suit la physique demandée
Lignes du tableau 2 (a) de l'article (version HTML arXiv), copiées cellule par cellule par notre code ; un en-tête à deux lignes s'affiche « groupe : colonne » ; un nom vide répète celui du dessus. Ce sont les chiffres des auteurs, non un test indépendant. Le tableau compte 11 colonnes ; 5 affichées. Non affichées : Cinématique (2 colonnes), Erreur de paramètre effectif (3 colonnes), Humain. Lignes : les 10 premières sur 11.
Sources
Les sources à partir desquelles cet article a été rédigé. Les liens ouvrent la page d'origine.